在飞书里查询 GitHub 更新:Dify Workflow + GPT-6 Astra + LangBot 实战
让 Dify 实时请求 GitHub API,代码节点提取版本信息,GPT-6 Astra 生成有来源的简报,再由 LangBot 返回。详解 Workflow 输入、HTTP、Code 和 summary 输出。
项目更新一多,群里的问题也很固定:“最新版本是什么?”“这次有哪些变化值得看?”直接让模型凭记忆回答,碰上刚发布的版本就不靠谱。
我们做了一个按需查询的 GitHub 简报助手:用户发消息后,Dify 真正请求 GitHub API,代码节点抽取发布信息,GPT-6 Astra 写成简短摘要,再由 LangBot 返回。下面用 LangBot 自己的公开仓库做例子;同样的方法也可以用在你关注的其他公开项目。
真实 API 数据生成的中文简报,保留版本、时间与 GitHub 原文链接。
先把 Dify 和 LangBot 跑起来
先安装 Docker Compose 和 Git,再分别按 Dify Docker Compose 部署文档 与 LangBot Docker 部署文档 启动两个服务。Dify 的基础步骤是克隆仓库、进入 docker 目录、将 .env.example 复制为 .env,再启动 Compose;LangBot 的文档提供完整的镜像和插件运行时配置。
本文截图来自 Dify 1.17.1、LangBot v4.10.11 的本机环境。我们把浏览器端口分别映射为 8088 和 5368;这是演示环境的自定义映射,官方默认部署通常分别使用 80 和 5300。如果沿用官方默认值,就打开 http://localhost 和 http://localhost:5300,不用为了对齐截图而改端口。各自创建管理员账户,并把界面语言设为 English。
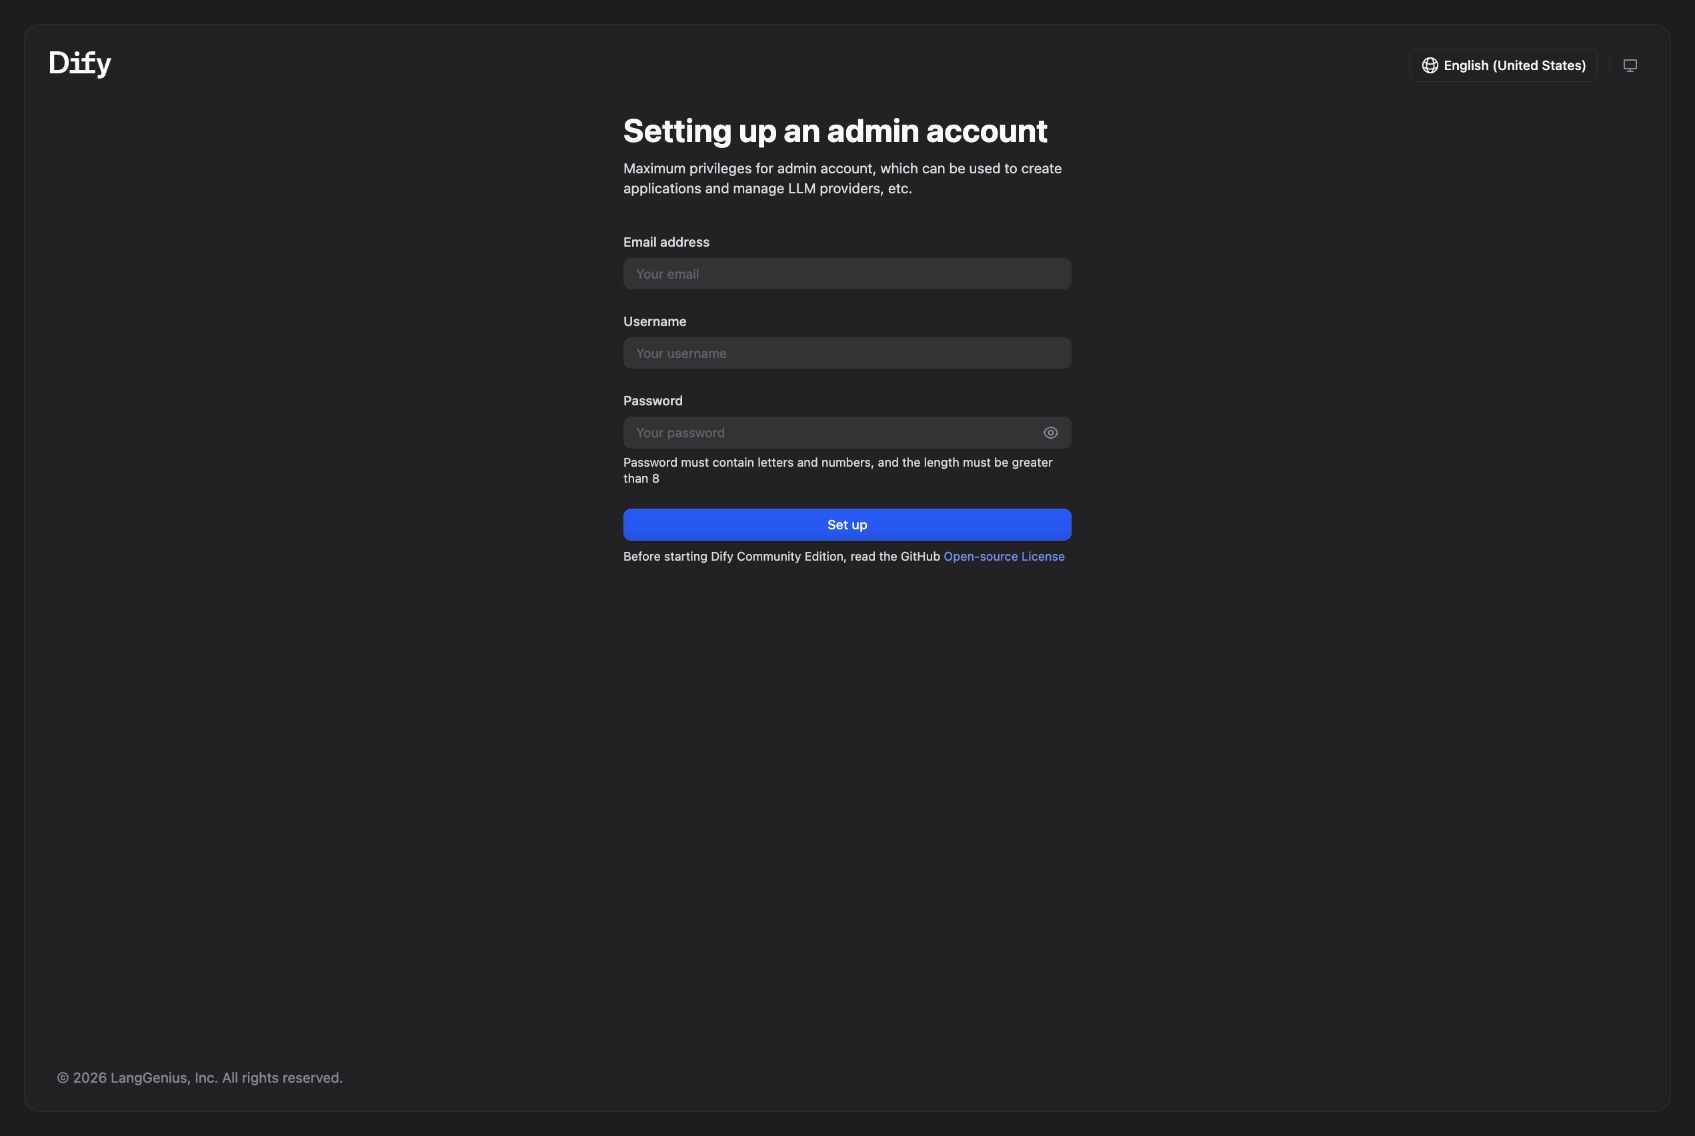
本地 Dify 的首次初始化页面。
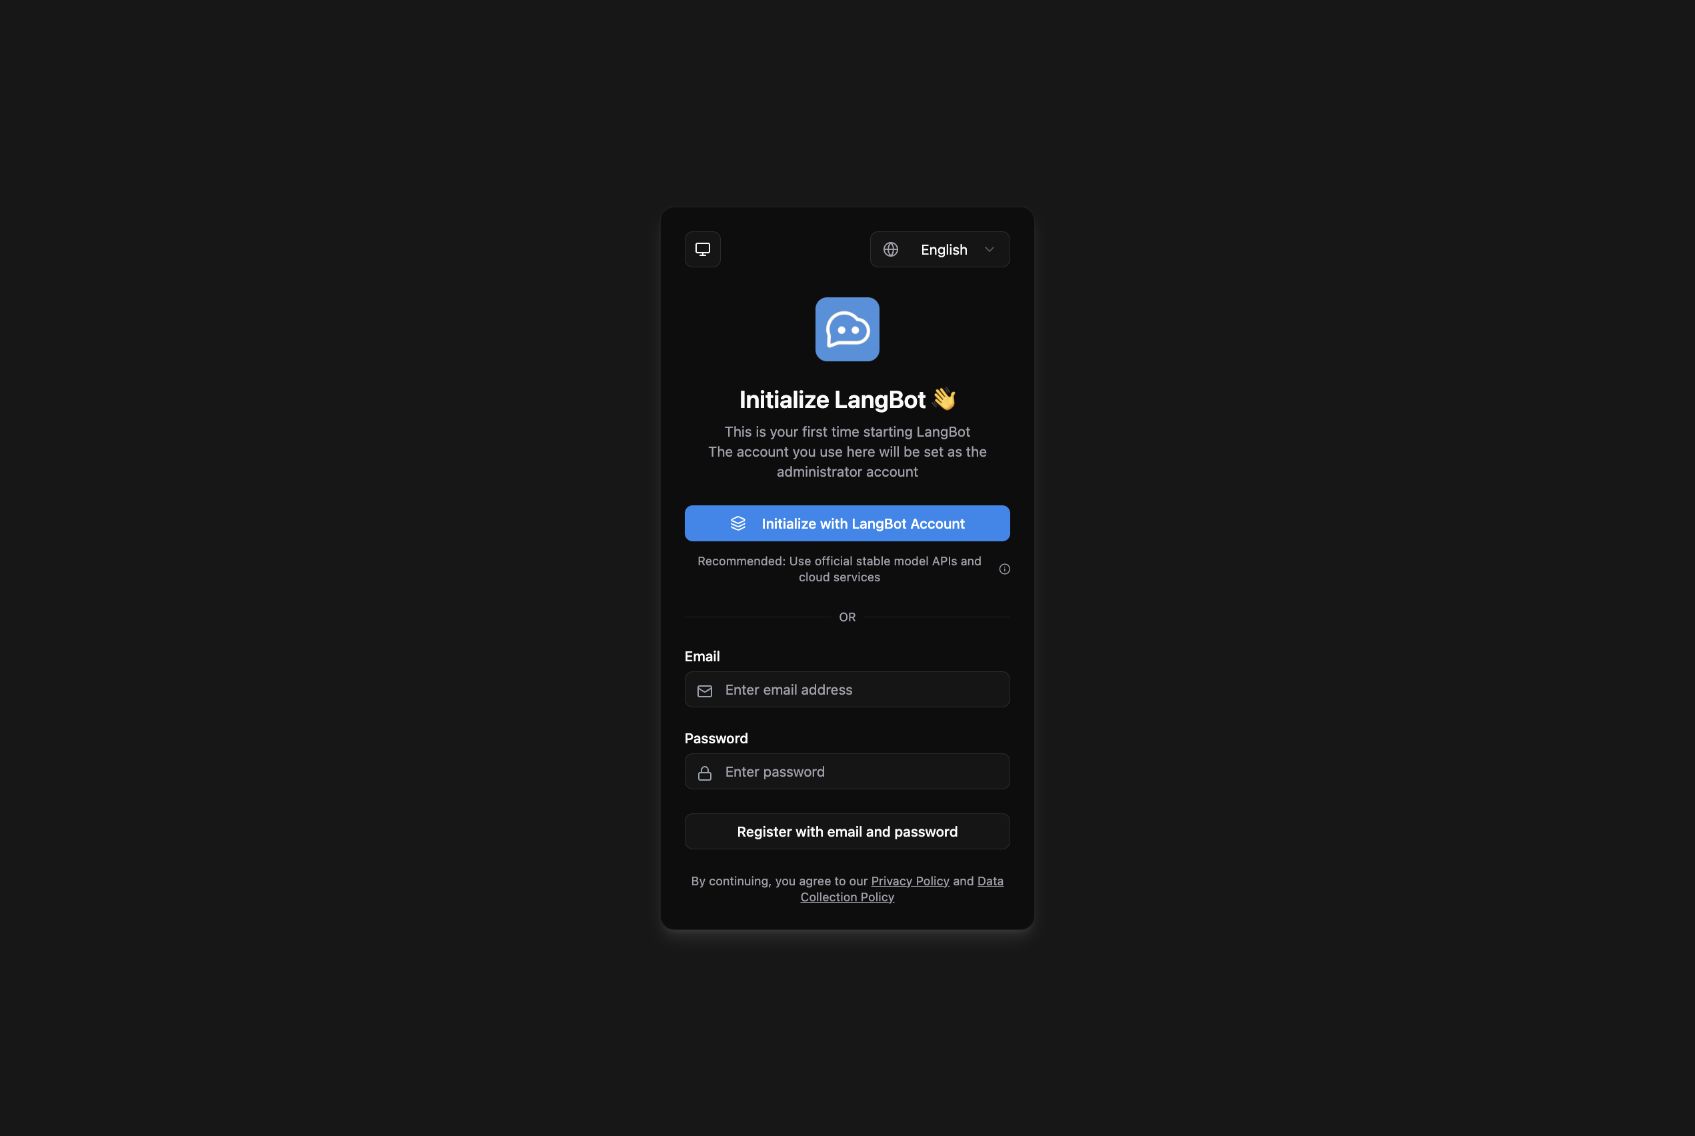
本地 LangBot 的首次初始化页面。
接入时最重要的是 LangBot 容器能访问 Dify。本次两个服务加入同一个 Docker 网络,因此 Runner 的 Base URL 使用 http://nginx/v1,其中 nginx 是 Dify 的服务名。你可以在两个 Compose 配置中为 Dify 的 nginx 和 LangBot 服务加入同一个外部网络;如果分别部署在不同主机,则填写 LangBot 能访问的 Dify HTTPS 地址并加上 /v1。下文表格里的 http://nginx/v1 都指本次共享网络环境,不能直接套到所有部署。容器内的 localhost 指向容器自己。
在 Dify 中配置 GPT-6 Astra
进入 Integrations → Model Provider,安装官方 OpenAI-API-compatible 插件,再点 Add Model。本次使用的插件版本是 0.0.66。
| 字段 | 本次设置 |
|---|---|
| Model Name / model name for API endpoint | gpt-6-astra |
| Model Type / Completion mode | LLM / Chat |
| Model display name | GPT-6 Astra |
| API Base URL | 你自己的 OpenAI 兼容服务地址,通常以 /v1 结尾 |
| API Key | 你的模型服务密钥 |
| API Type | Chat Completions API |
| Model context size / Upper bound for max tokens | 本教程设为 32768 / 4096 |
最后一行是这次演示的工作上限,不是对 Astra 完整规格的声明。保存时让 Dify 做连接验证,成功后再建应用。截图中的网关只是本次测试环境,实际使用时换成你自己的服务。模型参数和可用接口以所选服务为准。模型名称以你选用的服务实际提供的标识为准,本文保留本次实测的 gpt-6-astra。
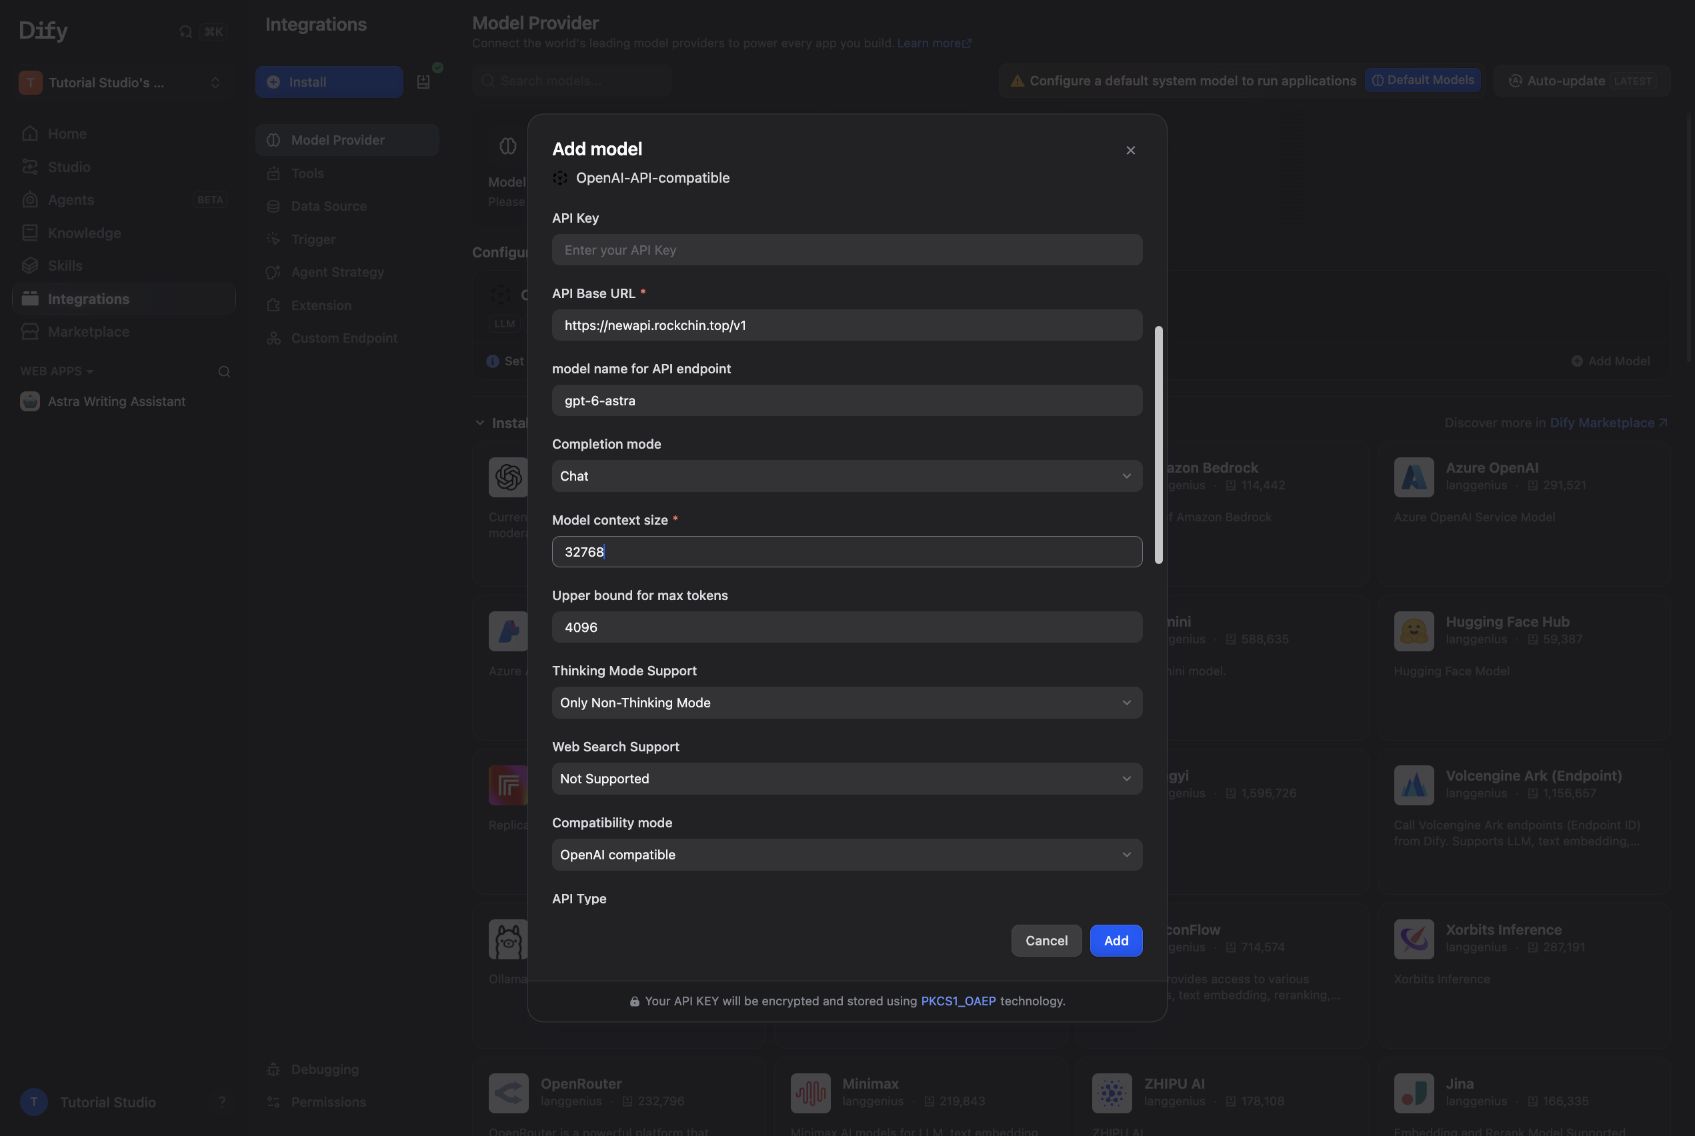
添加自定义模型。API Key 在截图前保持为空,实际运行时已配置。
用 Workflow,把数据获取放在模型之前
在 Dify 新建 Workflow,命名 Astra Release Briefing。这次不是 Chatflow,因为每条请求都可以独立查询最新发布记录。
流程是:
User Request → HTTP Request → Code → LLM → End
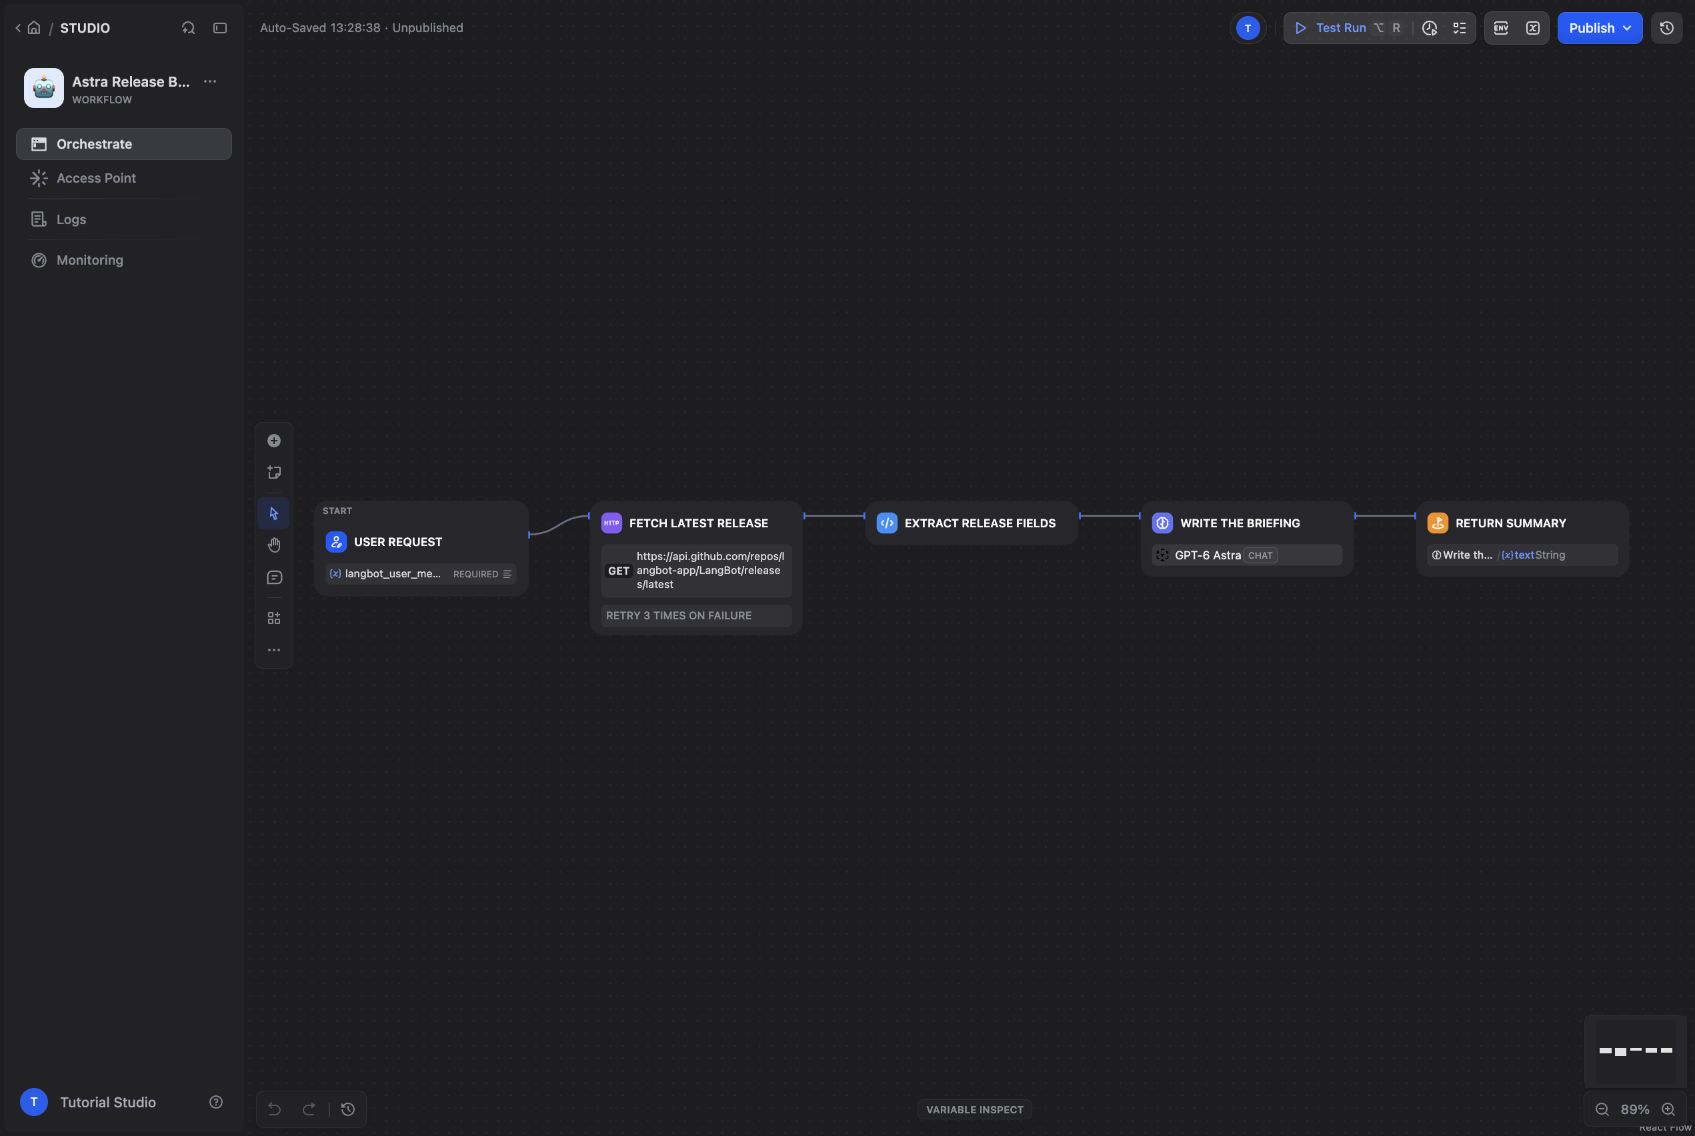
实际运行的 GitHub 简报工作流。
1. 用户输入字段要与 LangBot 对上
在 Start / User Request 节点添加必填段落字段:
langbot_user_message_text
LangBot 的 Dify Workflow Runner 会把当前消息文本放到这个字段中。不要随手改成 question 或 prompt,否则你在 Dify 手动测试能跑,接入 LangBot 时却可能缺少必填参数。
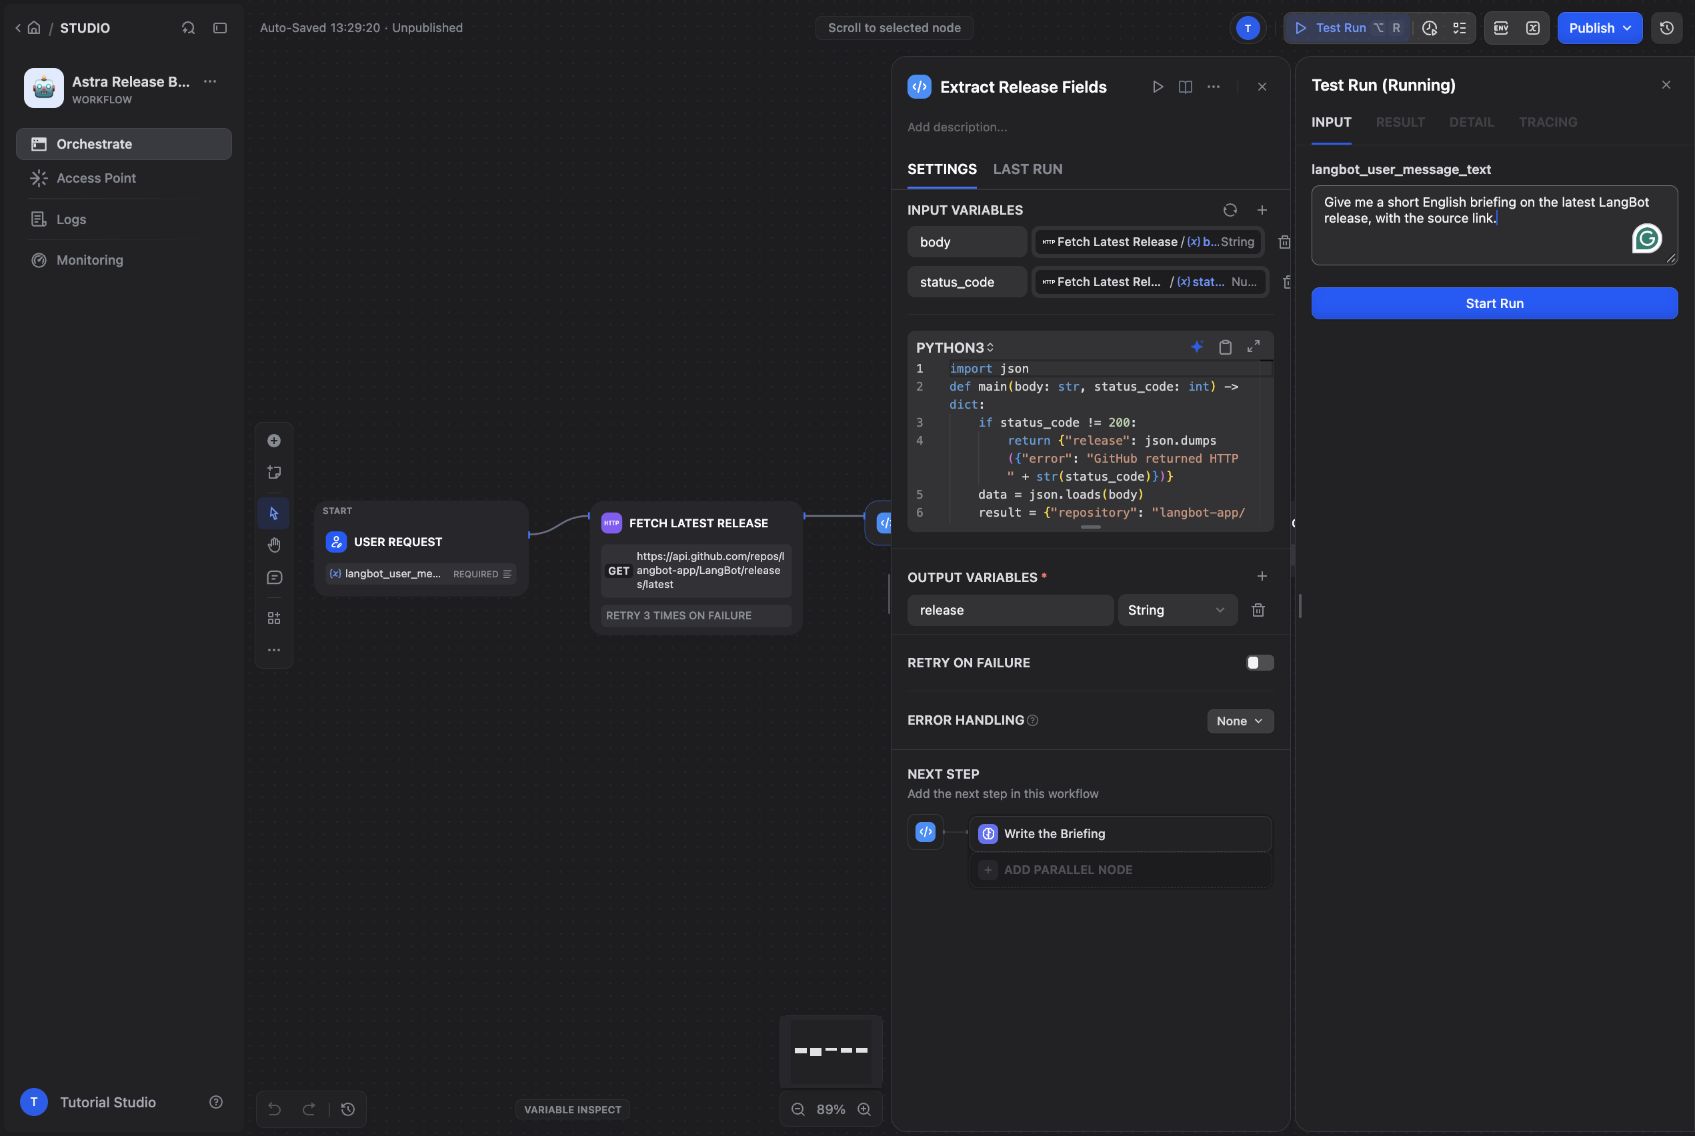
工作流运行表单中的输入变量名称。
2. HTTP 节点读取 GitHub
方法选 GET,地址:
https://api.github.com/repos/langbot-app/LangBot/releases/latest
请求头加上 Accept: application/vnd.github+json 和 User-Agent: LangBot-Dify-Tutorial。这是读取公开发布记录,本例不需要 GitHub Token。保留 SSL 验证,按实际网络设置连接和读取超时。
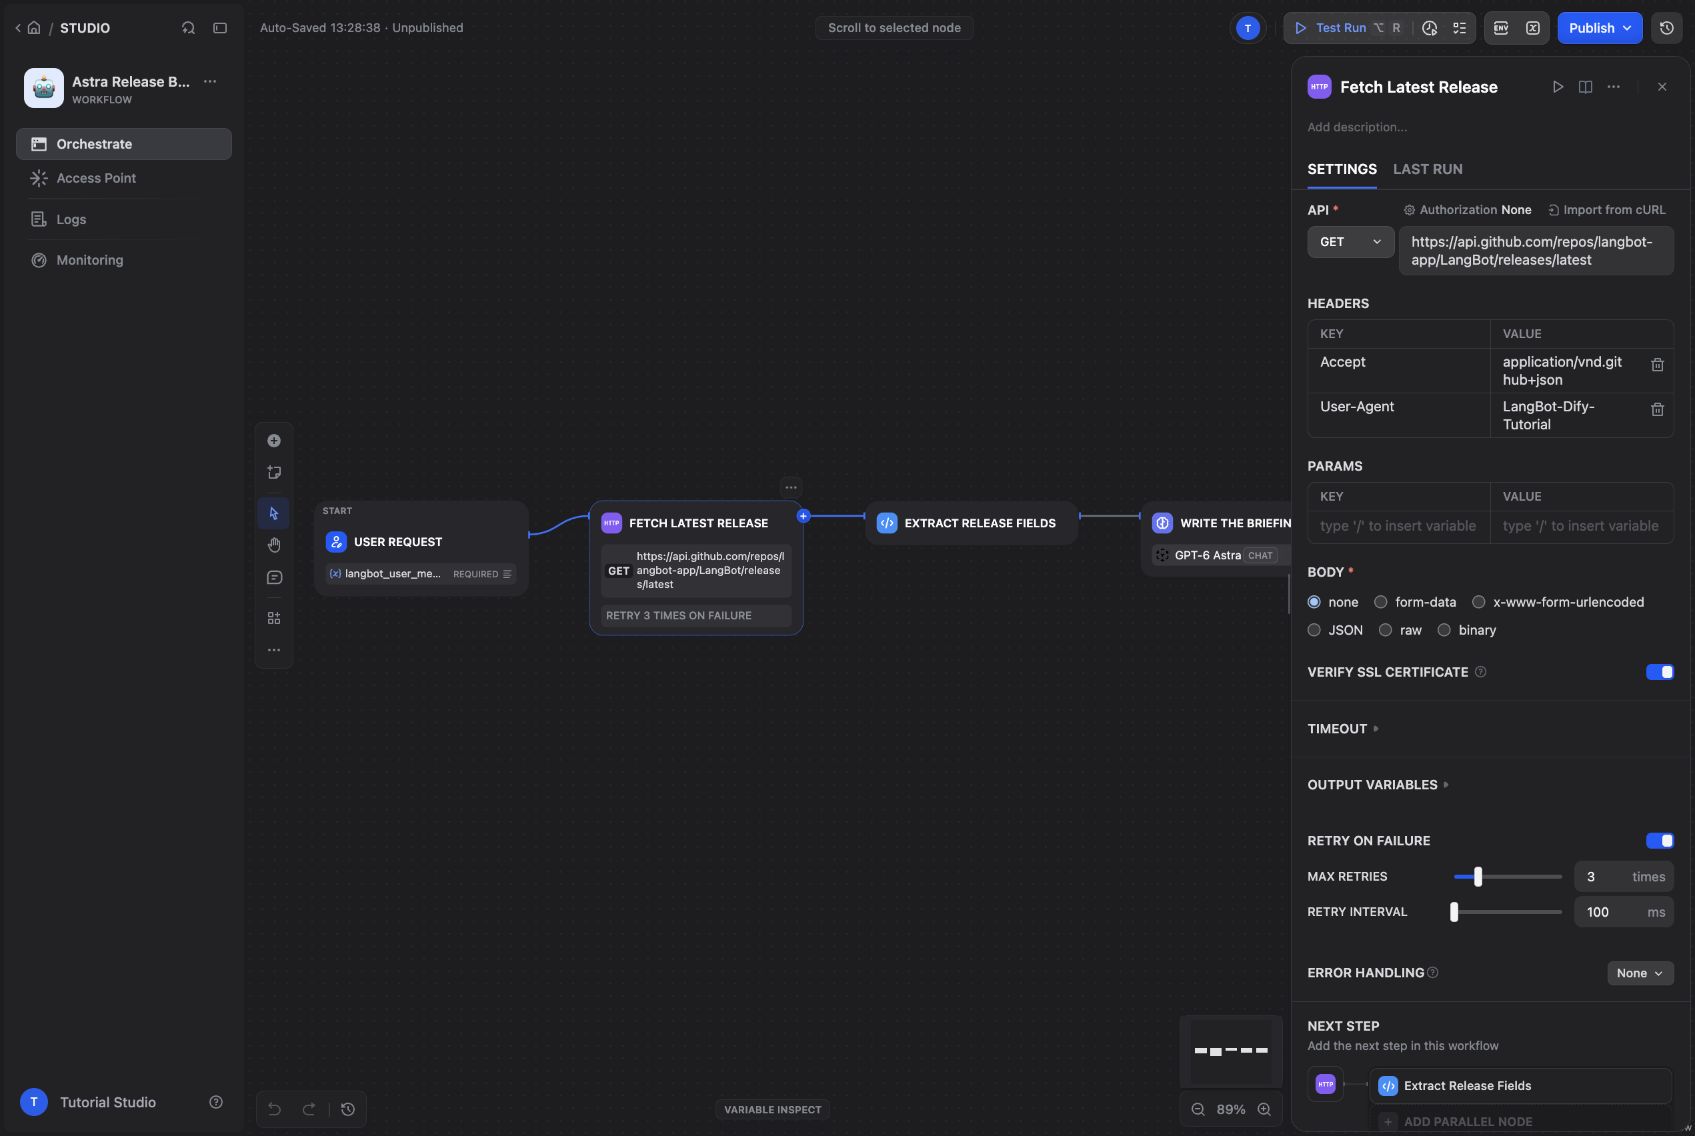
HTTP 节点直接查询 GitHub Releases API。
3. 代码节点缩小传给模型的数据
把 HTTP 的 body 和 status_code 分别传给代码节点。核心逻辑如下,完整代码在 DSL 中:
import json

def main(body: str, status_code: int) -> dict:
    if status_code != 200:
        return {"release": json.dumps({"error": f"GitHub HTTP {status_code}"})}
    data = json.loads(body)
    return {"release": json.dumps({
        "repository": "langbot-app/LangBot",
        "tag": data.get("tag_name"),
        "published_at": data.get("published_at"),
        "url": data.get("html_url"),
        "notes": (data.get("body") or "")[:14000],
    }, ensure_ascii=False)}
保留标签、发布时间、链接和发布说明就够了。没有必要把作者头像、各种 API URL 等字段全部塞进模型上下文。这里的代码只做提取,没有修改 GitHub 数据。
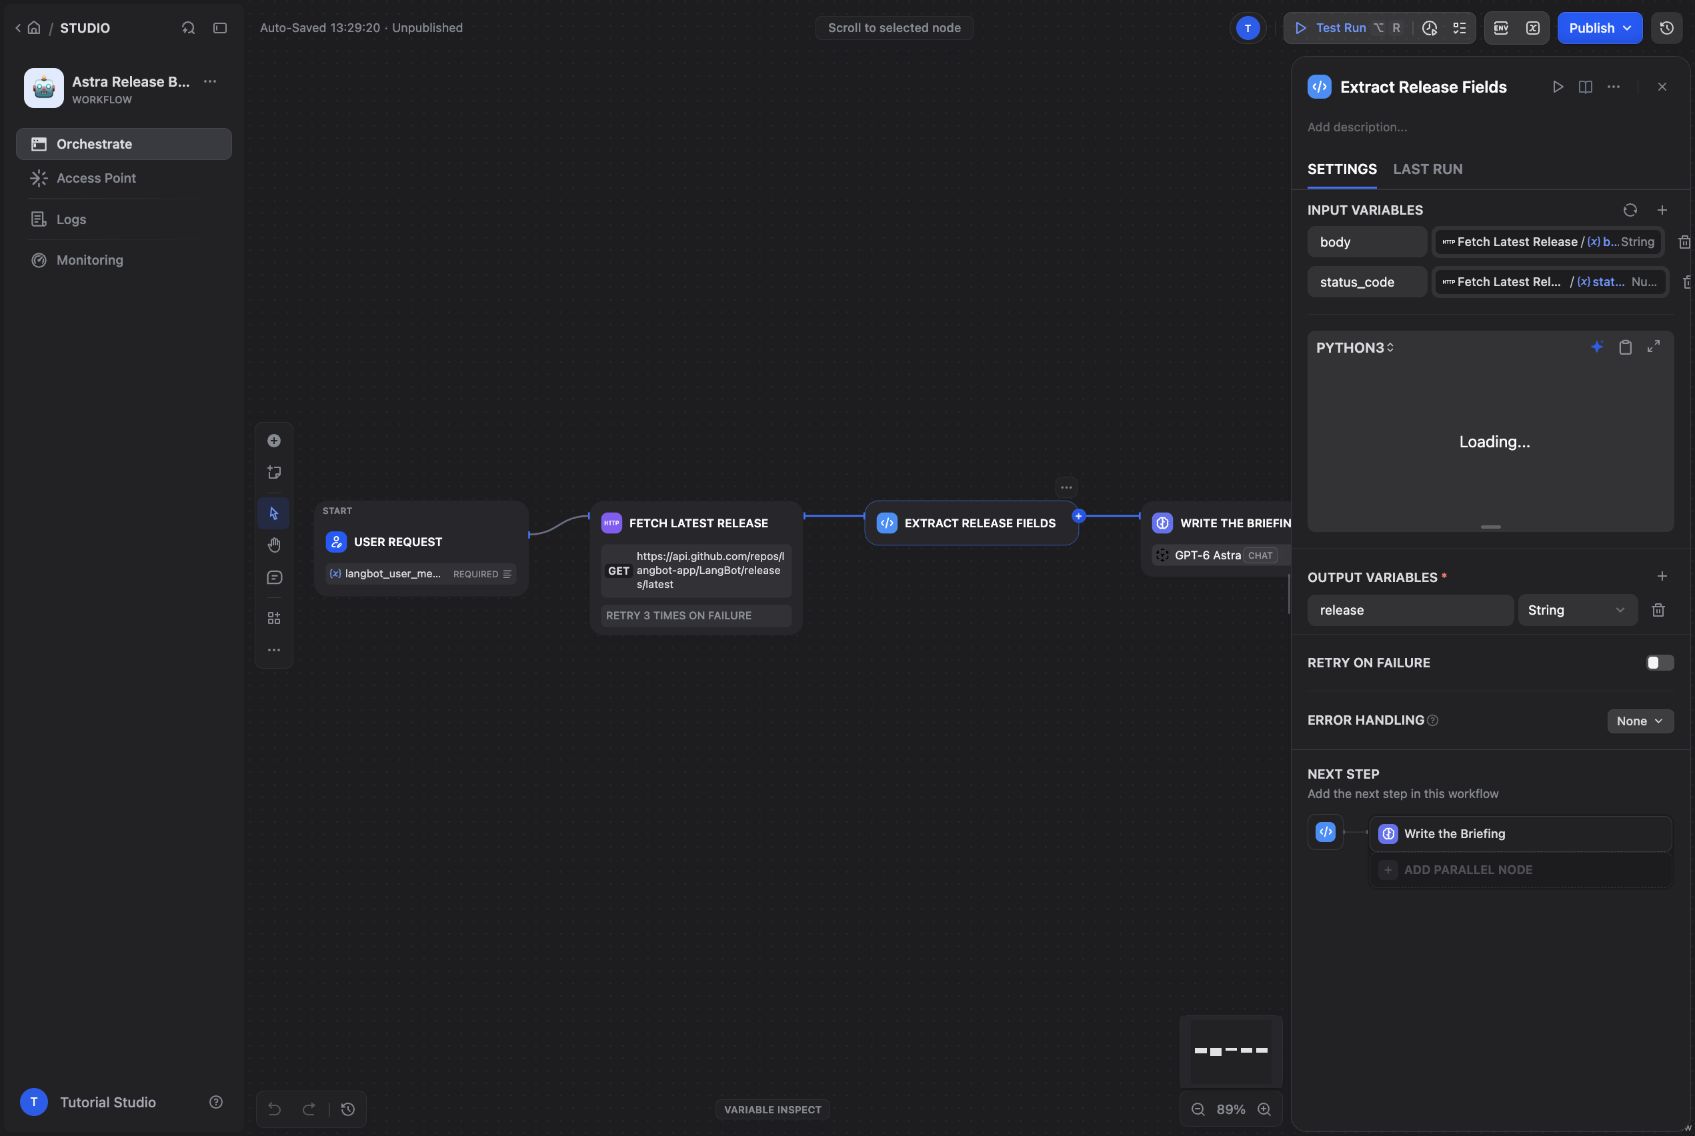
代码节点把原始 JSON 转成精简的发布资料。
4. LLM 写摘要,End 返回 summary
LLM 选择 GPT-6 Astra。提示词要求:用用户的语言回答,包含仓库、版本、发布时间、三个实用变化和原文链接;只使用 API 返回的资料,出错时说明查询失败。把用户输入和代码节点的 release 都放进 User 消息。
在 End 节点,把 LLM 的 text 映射到名为 summary 的输出。这个名字同样是接入约定,不能只看着节点连线完整就忽略它。
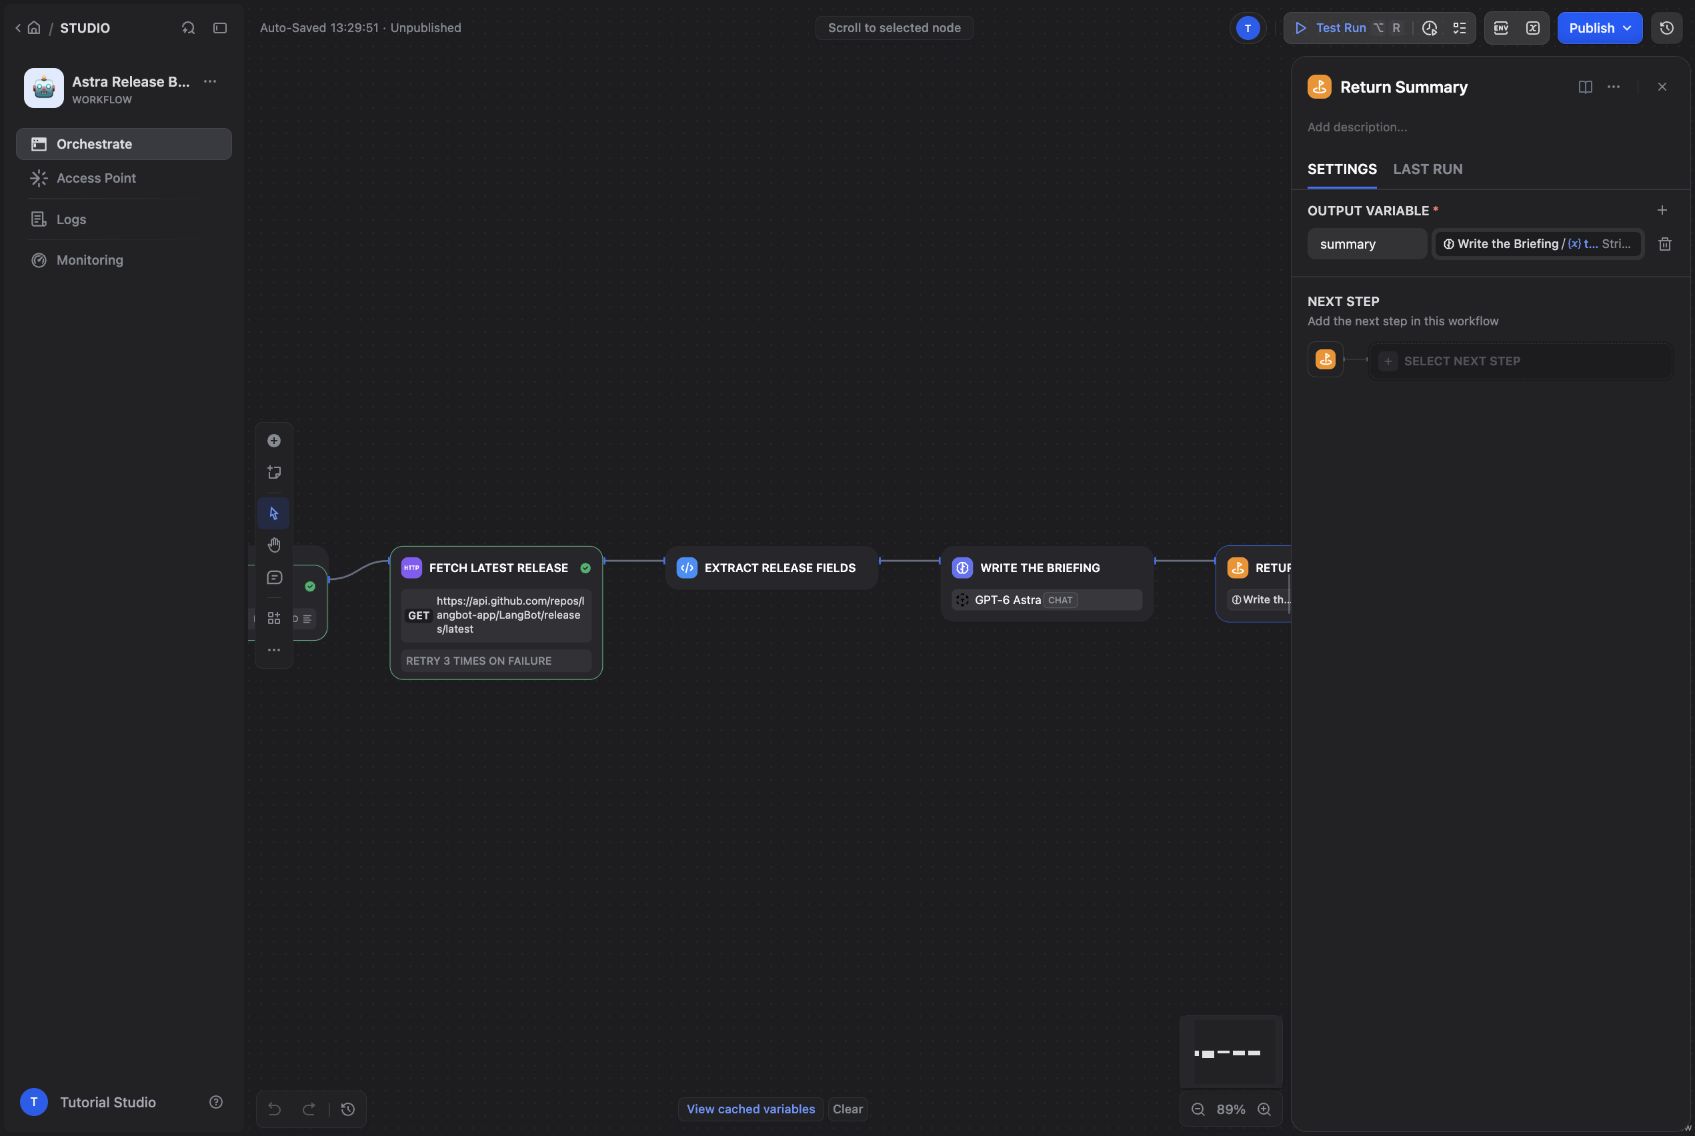
End 节点把模型文本返回为 summary。
先核对数据,再看摘要
我分别运行了英文和中文请求。两次都读取到 v4.10.11,发布时间为 2026-09-12 04:55:58 UTC,并附上对应的 GitHub Release 链接。摘要提到了知识库导入、监控统计和平台兼容性变化。
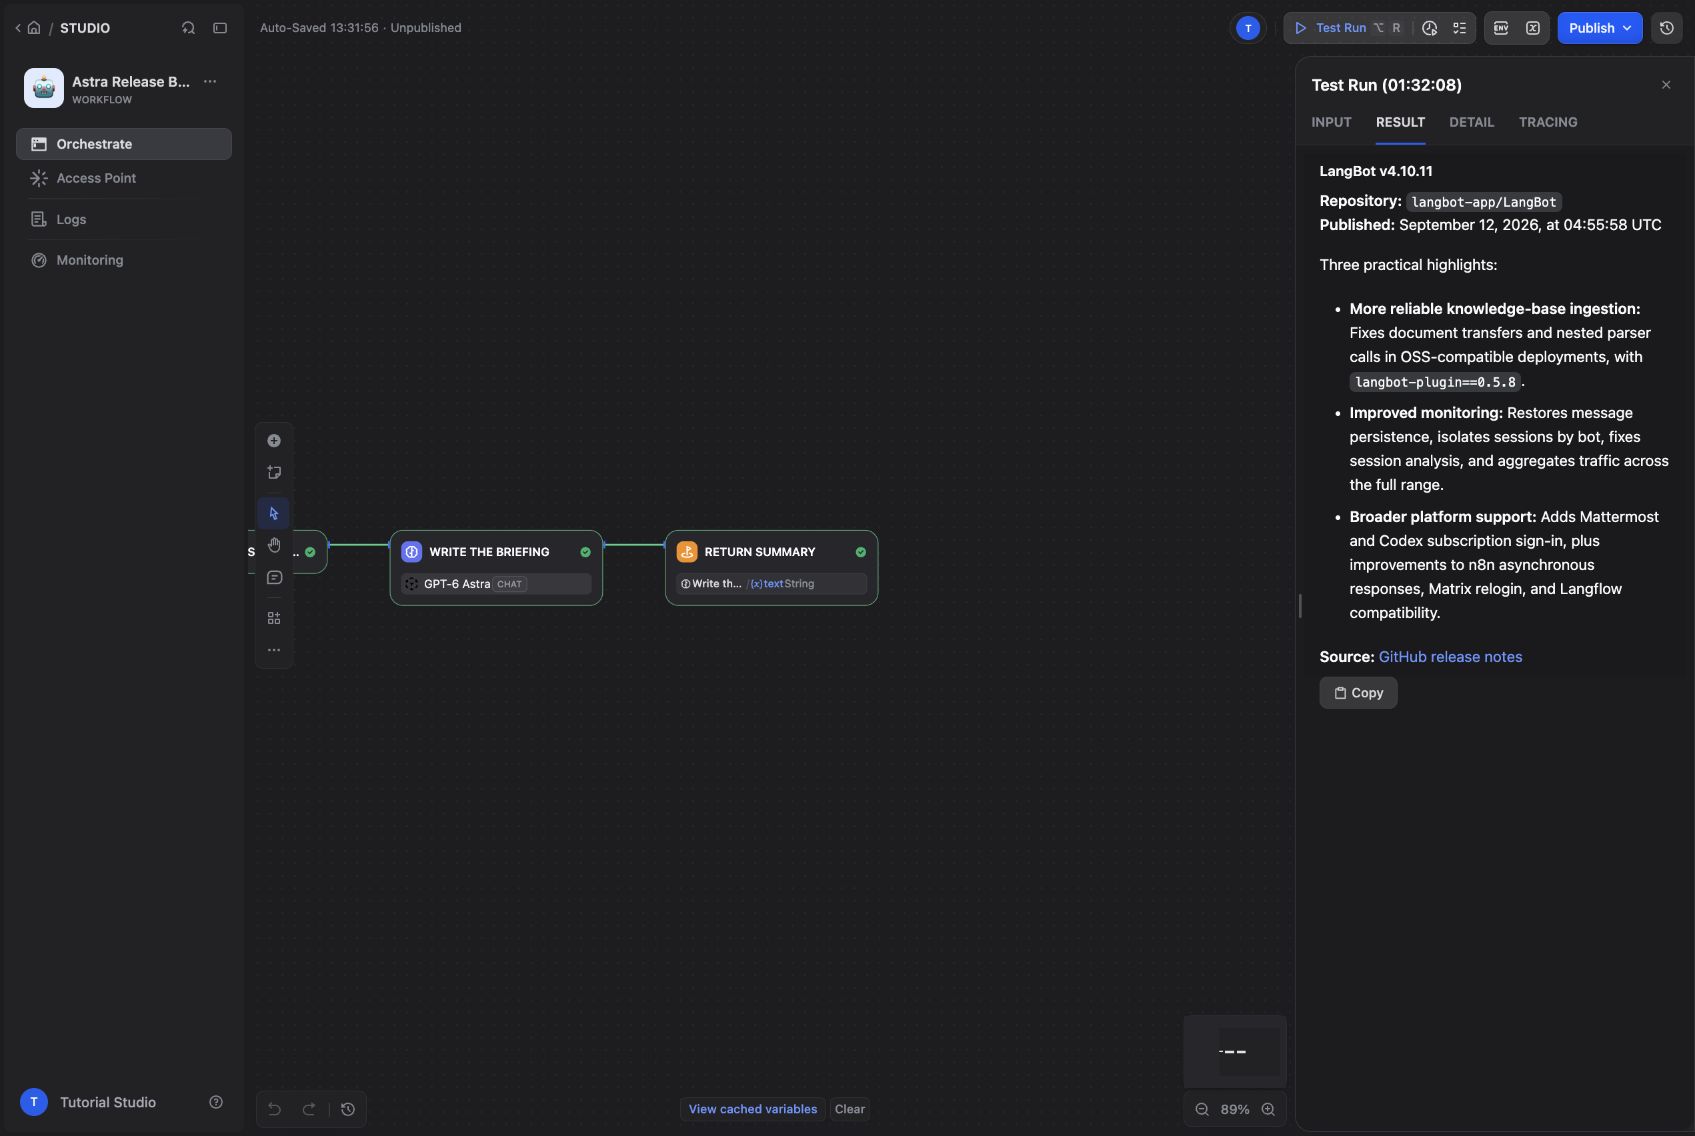
英文请求的真实运行结果。
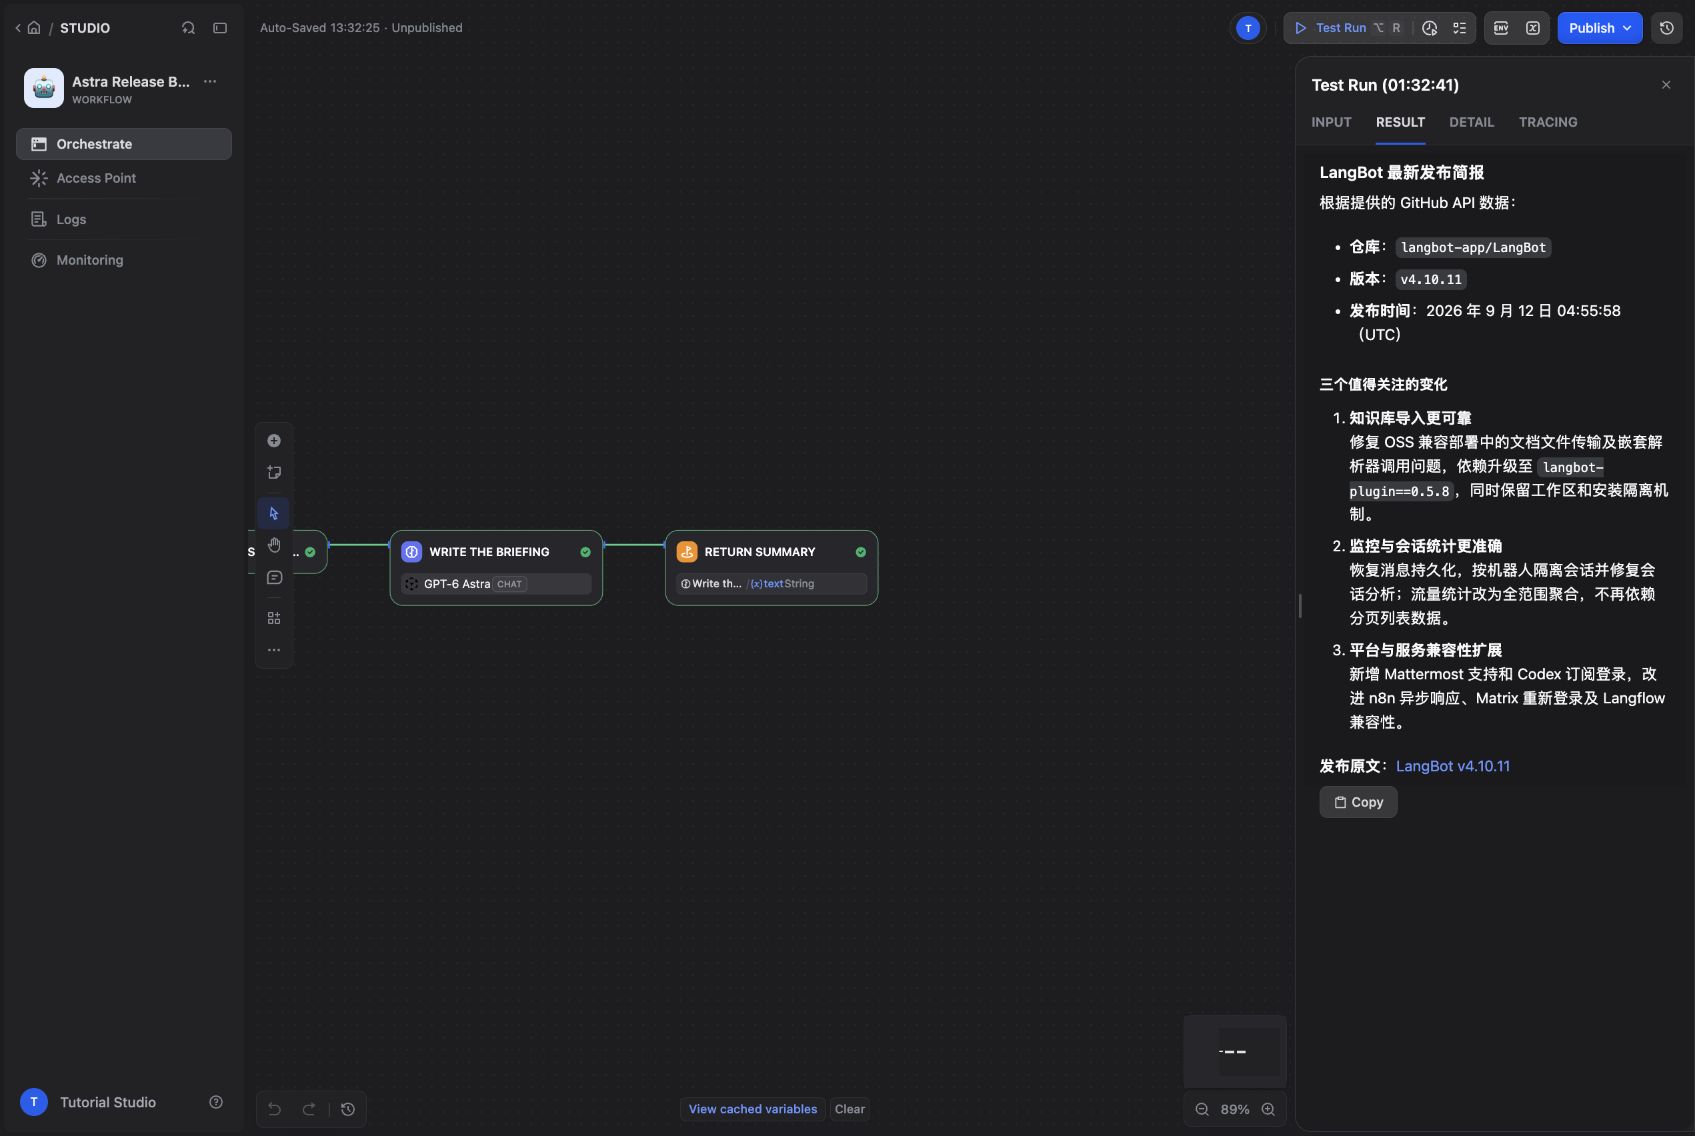
同一条工作流根据用户语言生成中文简报。
“最新”会随仓库发布变化,复现时不必追求和截图相同的版本号。应检查它是否与 API 当前返回的 tag_name、published_at、html_url 对得上。
用 LangBot 接住消息入口
在 Dify 点 Publish,发布当前版本。然后进入 Access Point → Backend Service API → API Key,创建这个应用自己的密钥。
打开 LangBot,点 Create Pipelines,命名为 Astra Release Briefing。进入 Configuration → AI:
| 字段 | 值 |
|---|---|
| Runner | Dify Service API |
| Base URL | http://nginx/v1 |
| App Type | Workflow |
| API Key | 刚创建的 Dify 应用密钥 |
这里粘贴的是 Dify 应用密钥,不是前面配置 Astra 的模型密钥。一个负责调用应用,一个负责调用模型,别混用。保存后打开 Debug Chat,先验证整条调用链,再接平台。
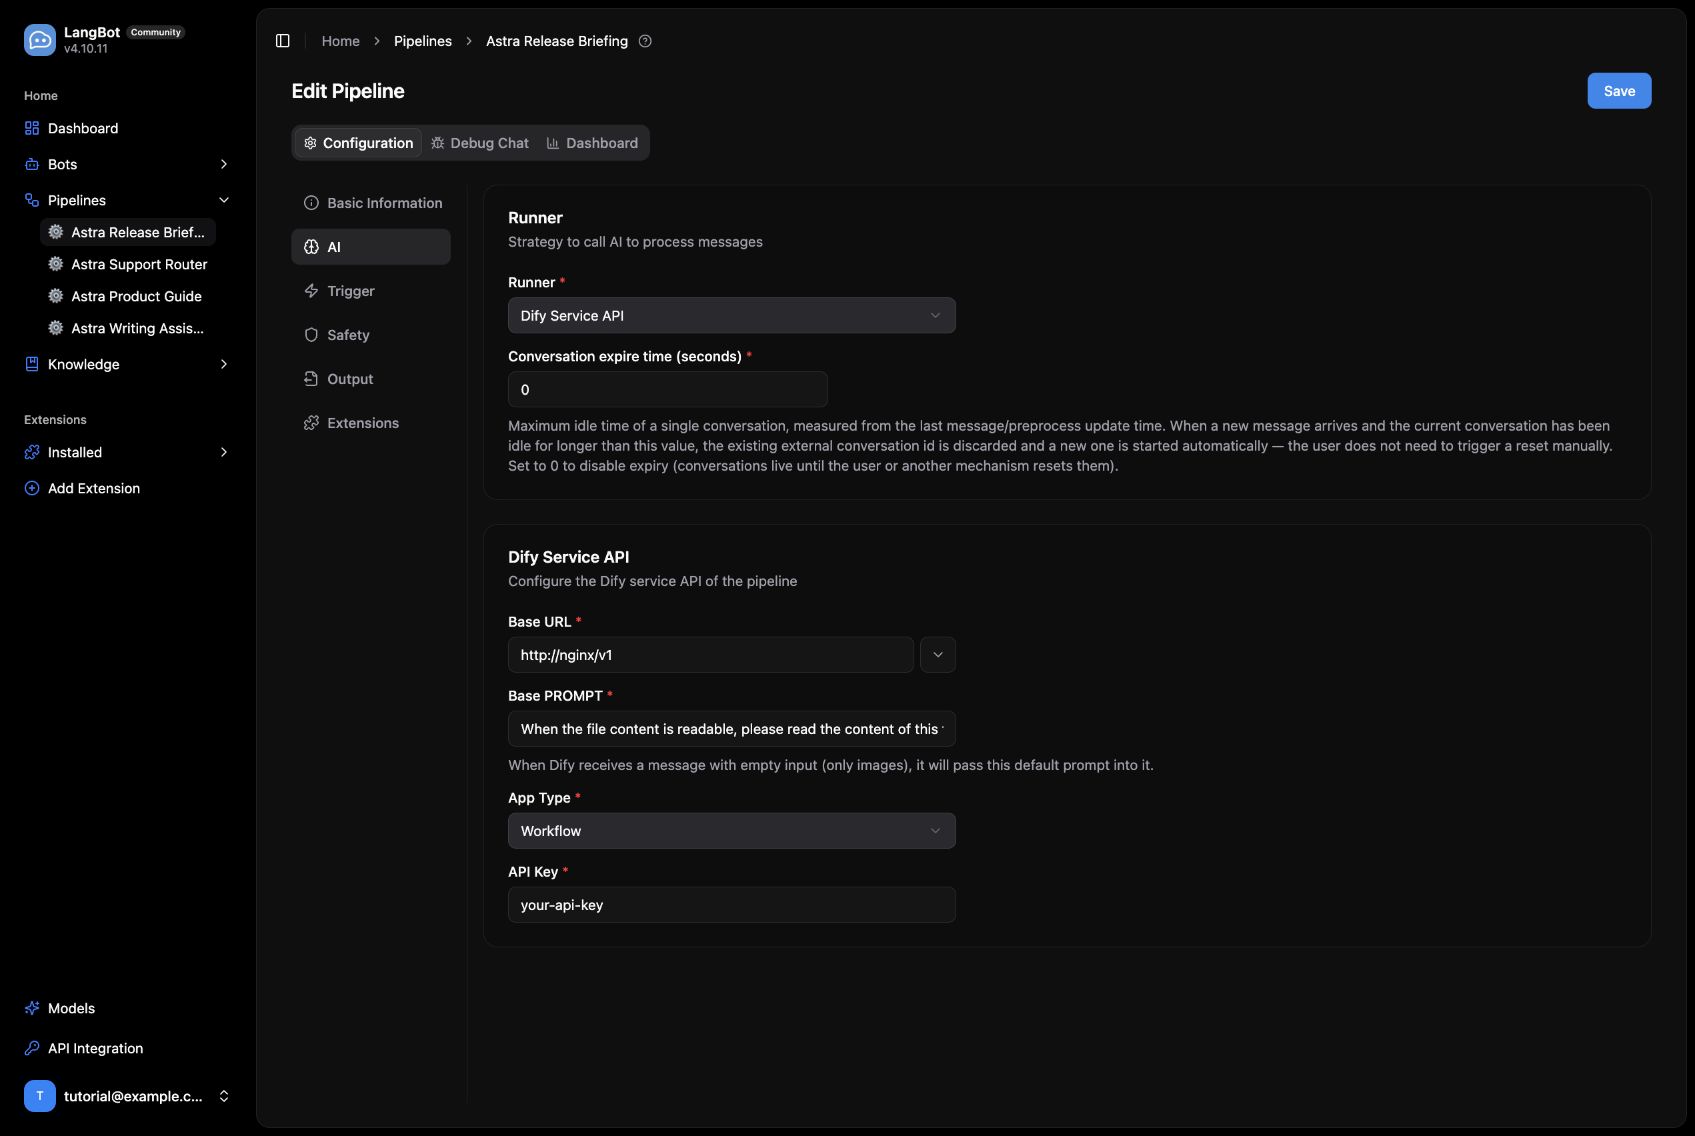
LangBot 的 Dify Runner 配置;截图时尚未填入应用密钥。
工作流接进聊天之后
我从 LangBot 发了英文查询,收到完整简报和来源链接。中文查询曾遇到一次上游 SSL 连接临时中断,重试后成功;这也提醒我们,截图里的成功运行不代表外部 API 永远可用。
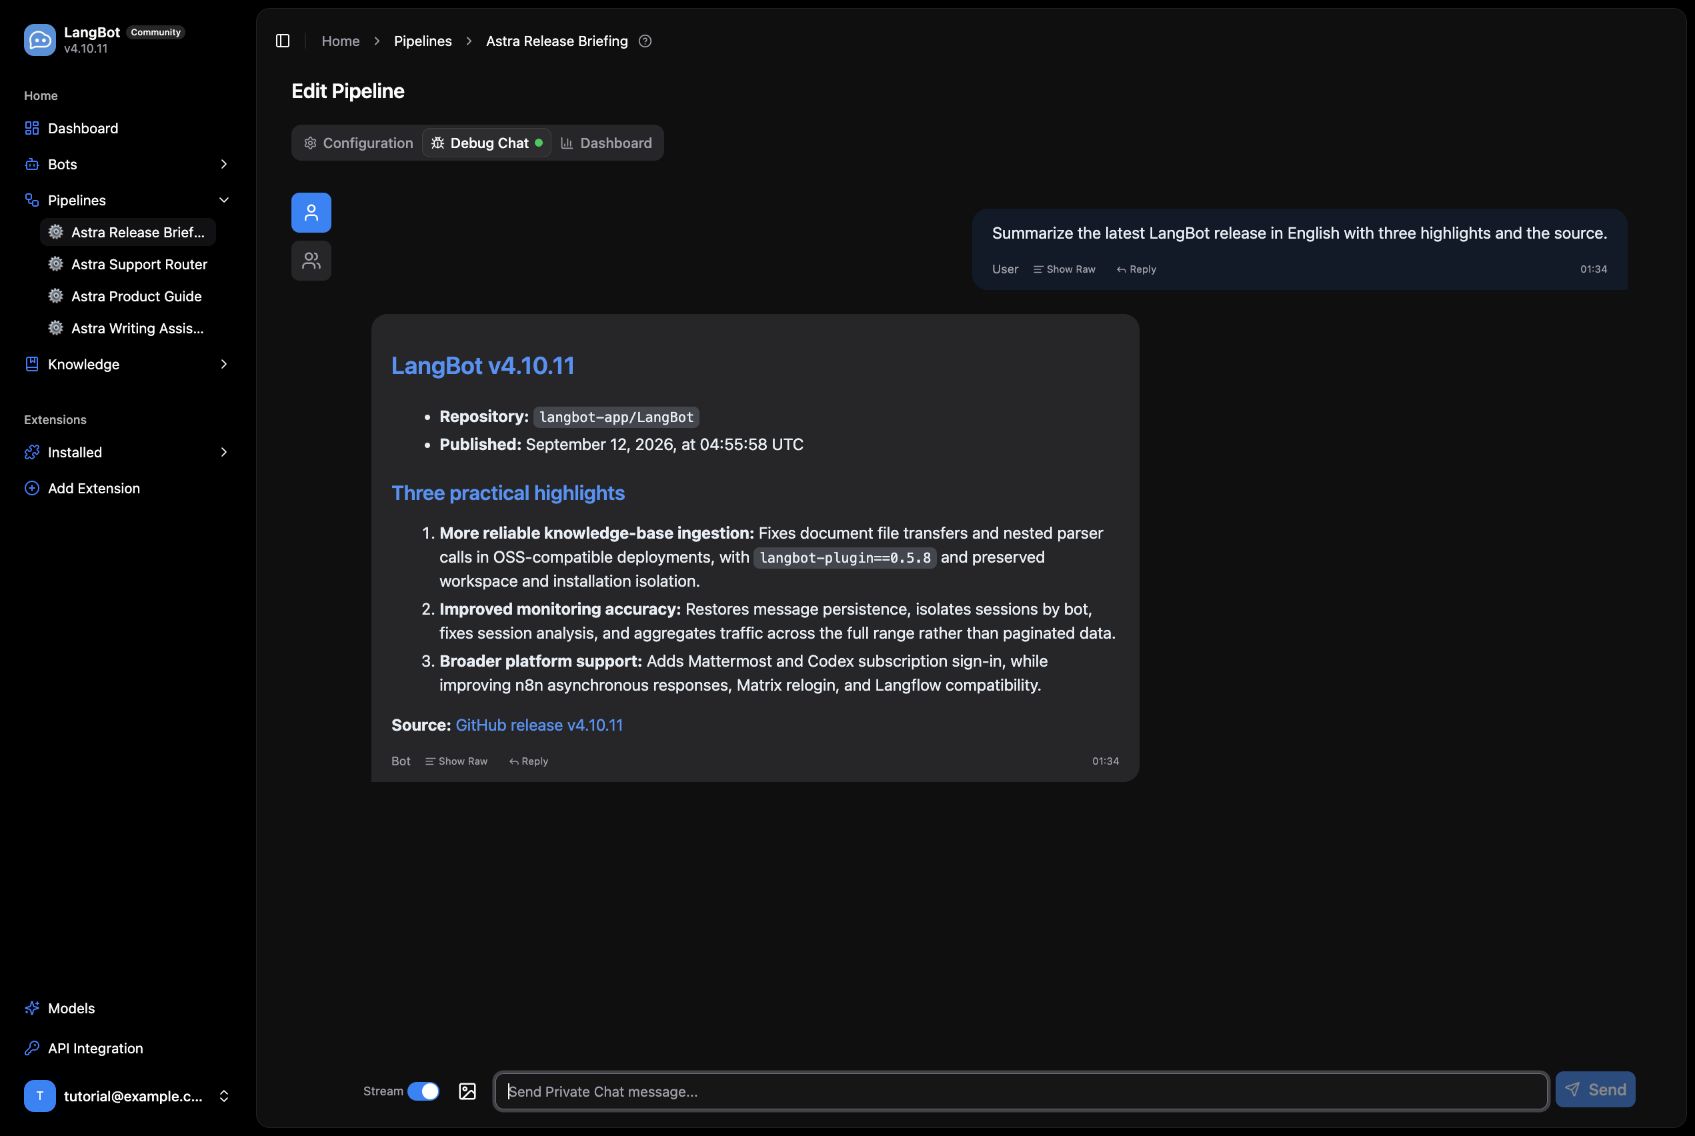
LangBot 收到工作流的英文 summary 输出。
中文重试成功后的简报内容。
如果接到飞书项目群,建议先设置提及触发。需要时问一次,就查一次,避免机器人反复刷屏。本文做的是按需查询;定时推送需要额外增加调度与发送逻辑。
扩展到其他仓库时,可以先复制应用并替换固定 API URL。等规则稳定后再加入仓库参数、输入校验和限流,不要让任意用户输入直接变成不受限制的请求地址。
接到飞书、钉钉、企业微信,以及其他消息平台
在 LangBot 点 Create Bots,选择适配器,填写平台提供的凭据。创建后把机器人绑定到刚才的流水线;检查 Trigger 中的私聊、群聊和提及规则,再按平台要求发布或邀请机器人。
本次实测覆盖 LangBot → Dify → GPT-6 Astra → LangBot 回复。以下是实际界面核对过的接入方式,平台账户与群聊没有在本次演示中授权连接。
| 入口 | 配置方式 |
|---|---|
| 飞书 / Lark | 选 Lark;可扫码创建应用,也可手填 App ID、App Secret、与平台一致的 Bot Name。中国平台域名选 Feishu,默认使用长连接;开发者后台配置消息权限、事件并发布应用。 |
| 钉钉 | 选 DingTalk;扫码或填写 Client ID、Client Secret。Robot Code 需从开发者后台复制;按文档配置 Stream 接收消息、机器人名称和需要的卡片模板。 |
| 企业微信智能机器人 | 选 WeComBot;长连接用 BotId、Secret,填写机器人名称。Webhook 模式另配 Corpid、Token、EncodingAESKey。两套模式不要混填。 |
| 企业微信内部应用 / 微信客服 | 分别选 WeCom 或 WeComCustomerService,按各自后台填写企业与应用凭据、Token、EncodingAESKey,完成 HTTPS 回调和可信 IP 配置。内部应用不能直接当群机器人使用。 |
| 微信个人会话 | 选 OpenClaw WeChat,通过界面的二维码授权登录,按适配器说明接入。 |
| 微信公众号 | 选 Official Account,填写 App ID、App Secret、Token、EncodingAESKey,配置公网回调与 IP 白名单。根据接口限制选择回复模式;耗时较长时可能需要用户再发一条消息取回结果。 |
| QQ:OneBot v11 | 运行兼容 OneBot v11 的协议端,配置反向 WebSocket 到 LangBot 的监听端口,两侧 Access Token 保持一致;演示环境的 Compose 把主机 2288 映射到容器 2280。 |
| QQ 官方机器人 | 选 QQ Official API;可扫码绑定或填写 App ID、Secret。当前界面说明 Token 可留空;接收模式、沙箱范围、发布审核以 QQ 官方及适配器文档为准。 |
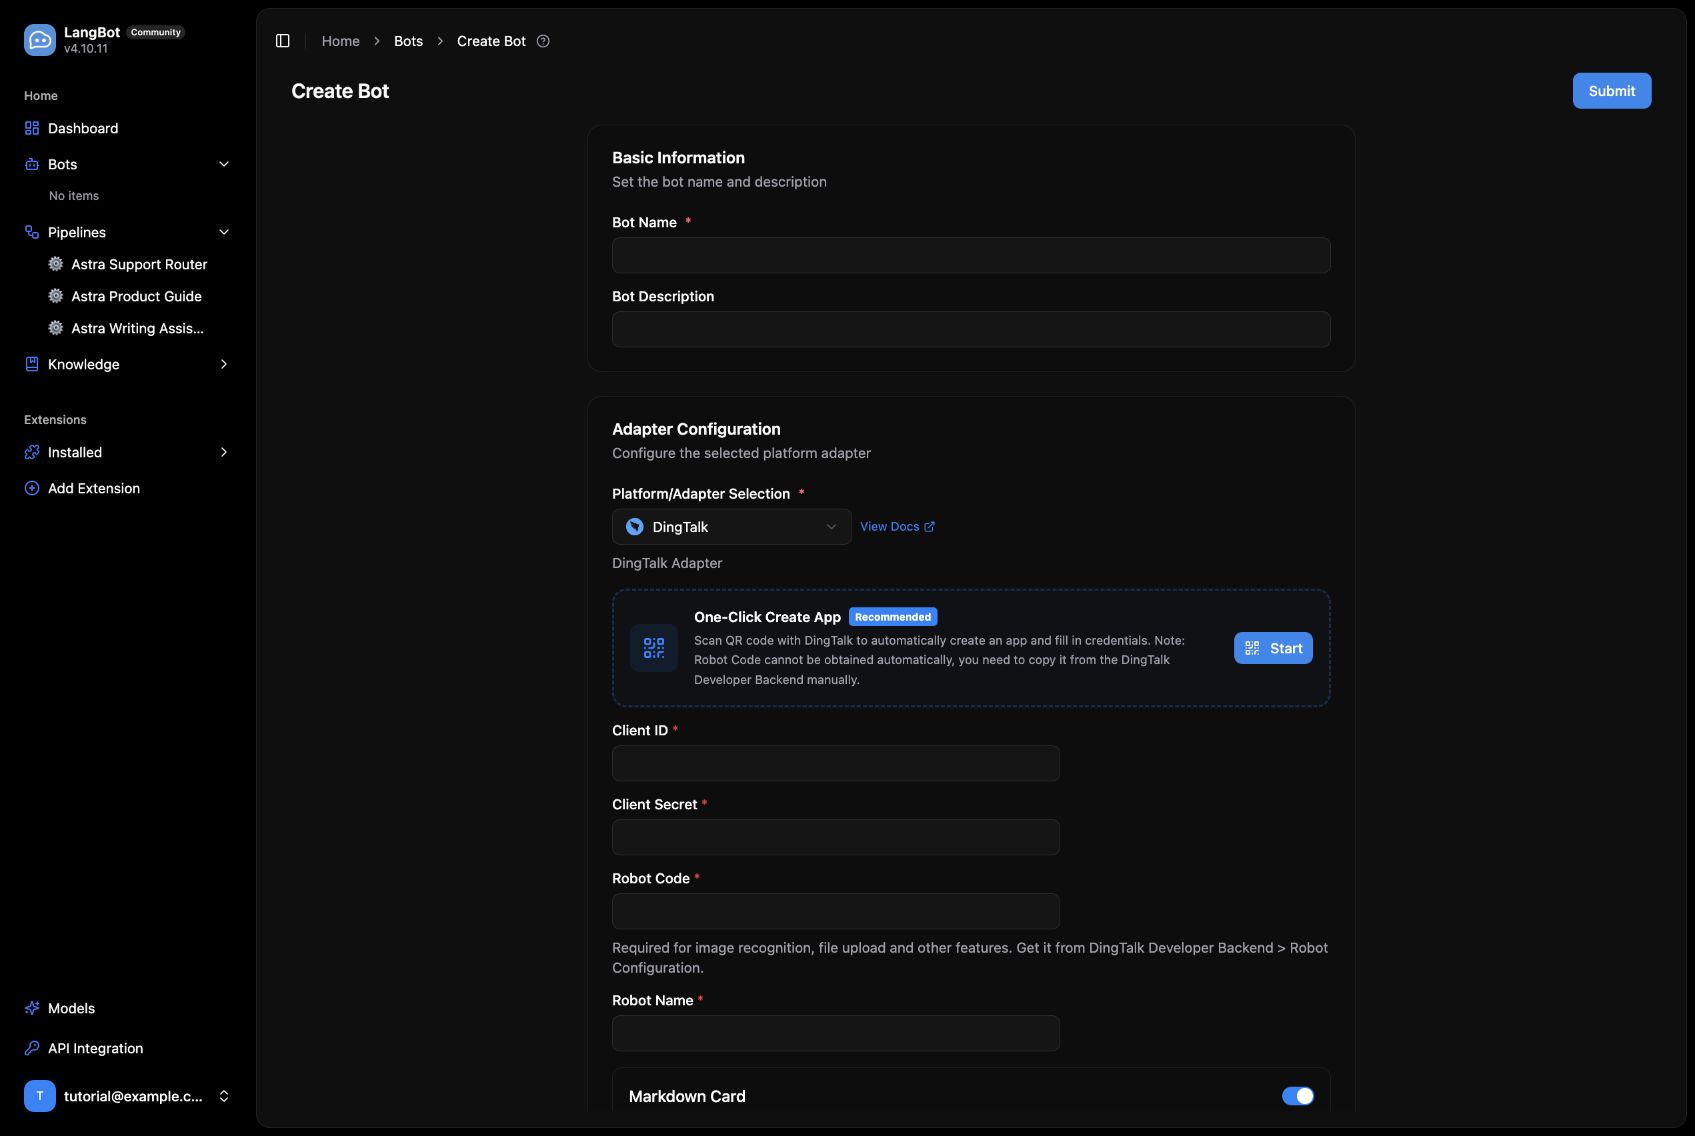
钉钉适配器的凭据、Robot Code 与卡片配置。
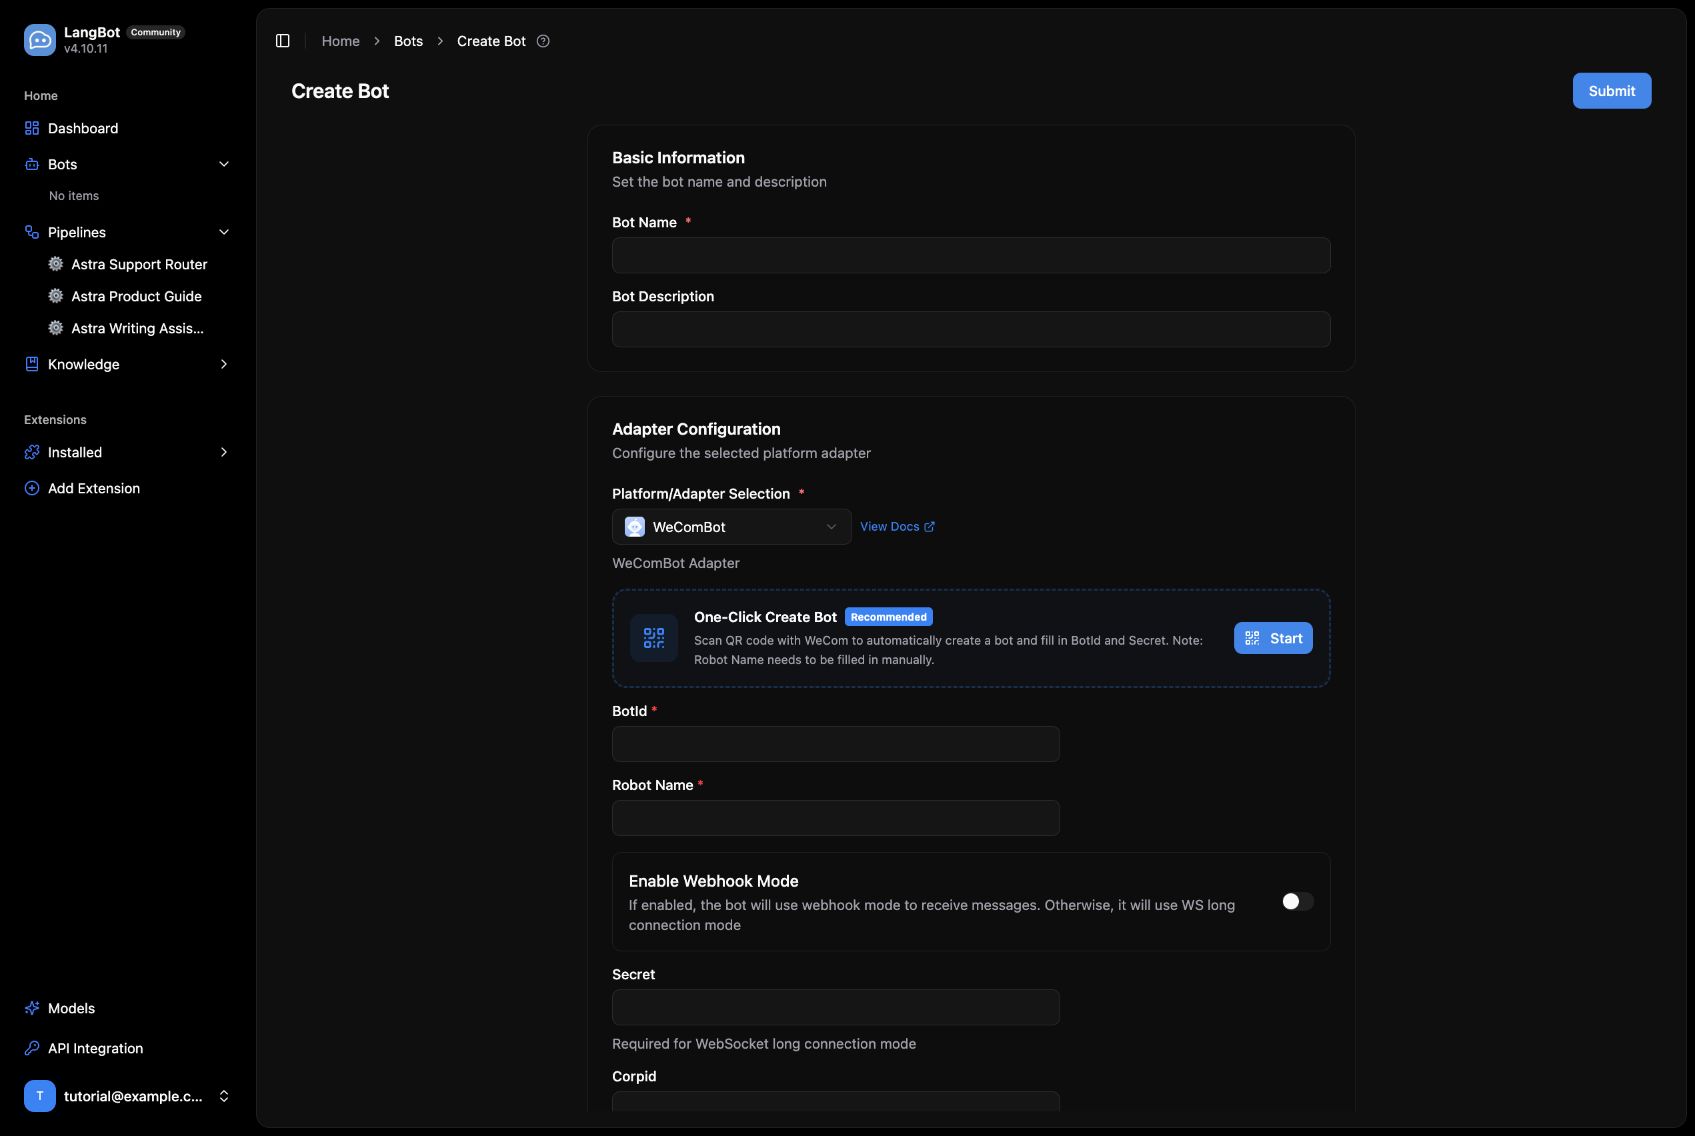
企业微信智能机器人的长连接与 Webhook 配置项。
LangBot 的适配器列表还包括 Discord、Slack、Telegram、LINE、Mattermost、Matrix、KOOK、Satori、HTTP Bot、Page Bot 和 WeChatPad。每种适配器需要的权限、回调和协议不同,不是填一个通用 Token 就全部接通。完整入口见 LangBot 平台文档。
如果只是想先模拟 QQ 消息,可以使用 matcha 之类的 OneBot 测试端;本文展示的对话来自 LangBot 自带 Debug Chat,没有把模拟对话当作真实群消息。
几个容易卡住的地方
遇到问题先按链路定位:Dify 预览能否回复、应用是否已 Publish、LangBot 的 Base URL 是否包含 /v1、应用类型是否正确,最后才看平台事件是否到达。如果改过 Dify 服务密码,Redis 与 Celery、Sandbox 与代码执行客户端的配置必须成对修改。
本机部署还遇到过代理软件返回虚拟 DNS 地址,导致 Dify 的 SSRF 代理拒绝插件下载。修好 DNS 后恢复,没必要关掉证书校验或内网访问保护。一次外部 API 的临时失败也不能当作模型或平台已经接通的证明,重试后仍应检查运行记录。
项目入口:LangBot 和 Dify。截图和测试日期为 2026 年 9 月 16 日,后续版本的菜单名称可能会变化。